

ENTERPRISE DATA / INDUSTRIAL AI
nimitFlowเชื่อมข้อมูล เครื่องจักร
และ AI ในระบบเดียว
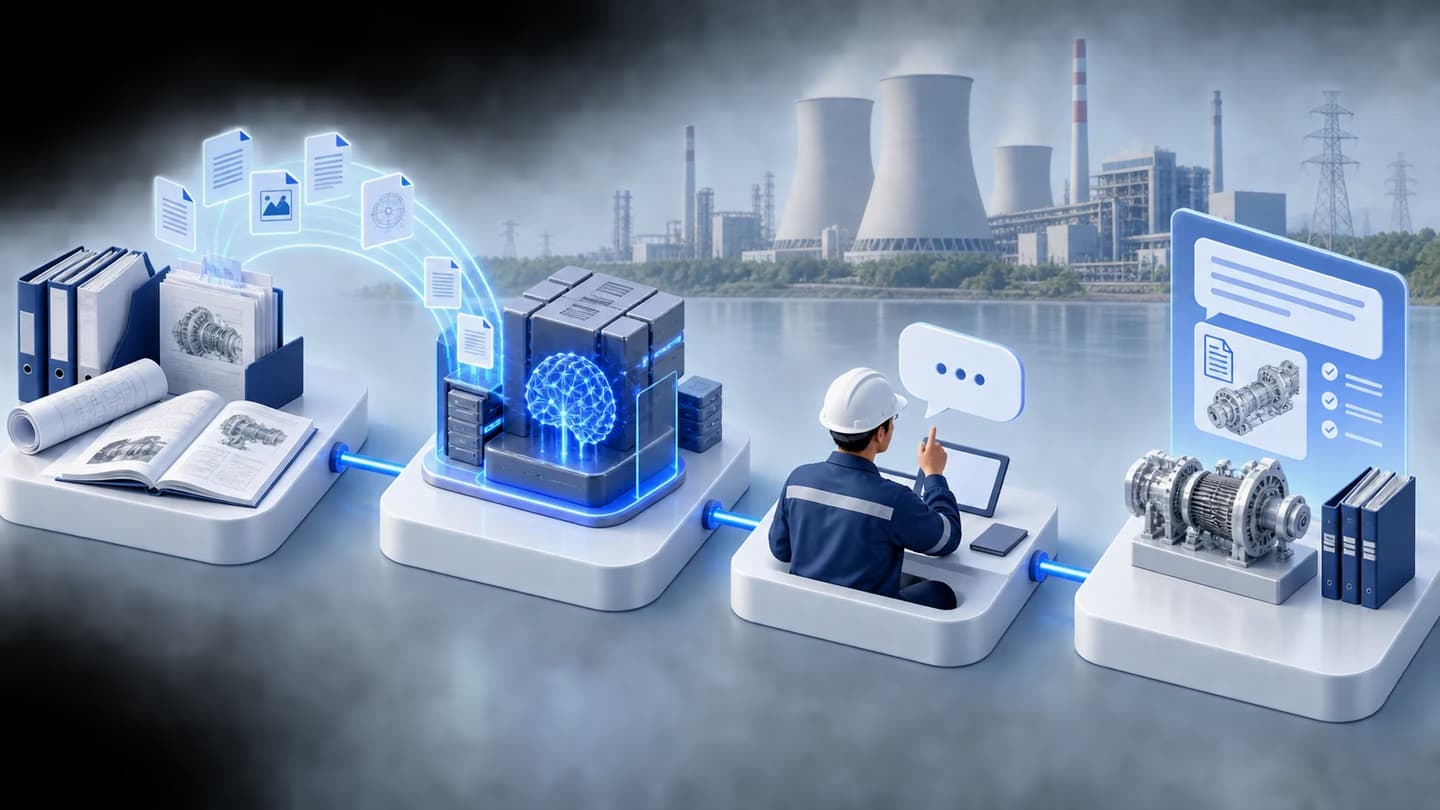
nimitFlow เป็นแพลตฟอร์ม Low-Code สำหรับเชื่อมข้อมูลและสร้างงานอัตโนมัติ เริ่มจากงานหนึ่งในองค์กร แล้วต่อยอดสู่คลังข้อมูลกลาง การกำกับดูแลข้อมูล และระบบโรงงานที่ใช้ข้อมูลร่วมกัน
เริ่มต้น 8,000 บาท/เดือนราคา Cloud เริ่มต้น · งาน Enterprise และระบบเชื่อมเพิ่มเติมประเมินแยกตามโครงการ
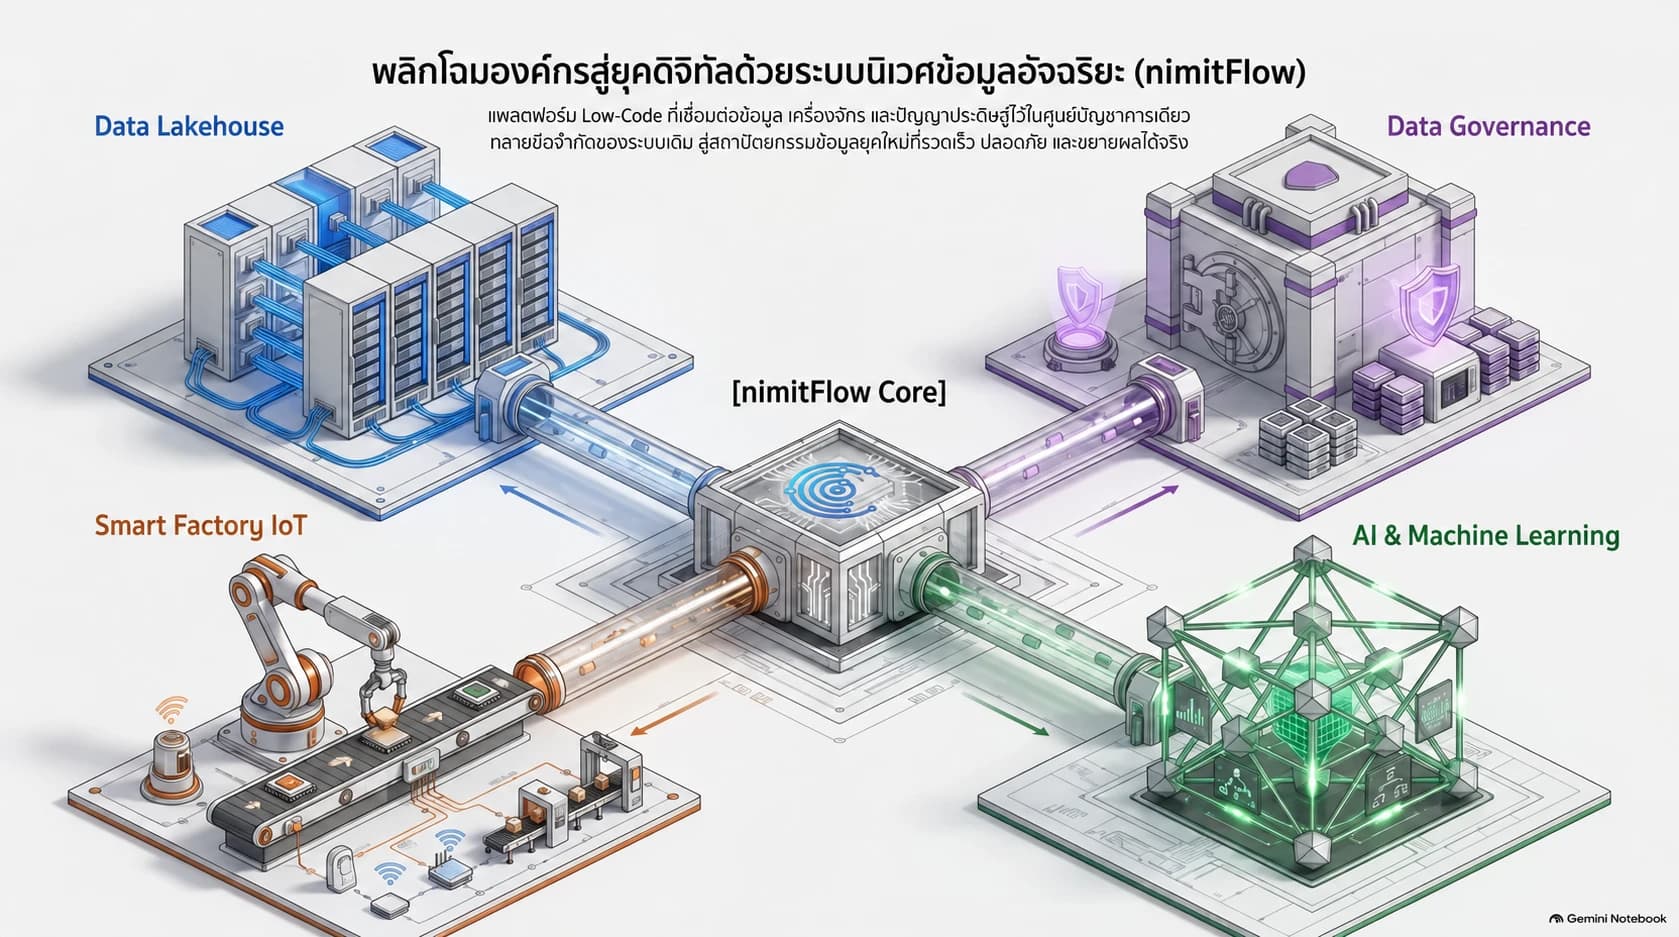
เริ่มจากงานที่ต้องการเชื่อม แล้วขยายเป็นระบบเดียวกัน
ใช้ nimitFlow เป็นแกนรับส่งและประมวลผลข้อมูล เลือกคลังข้อมูล เครื่องมือกำกับดูแล และโมเดล AI ให้ตรงกับงาน
01 / DATA FOUNDATION
รวมข้อมูลให้พร้อมใช้
รับข้อมูลจากระบบเดิม ฐานข้อมูล API และหน้างาน เข้าสู่เส้นทางข้อมูลที่ตรวจสอบได้
02 / DATA GOVERNANCE
รู้ที่มาและผู้ดูแลข้อมูล
กำหนดเจ้าของข้อมูล คำอธิบาย คุณภาพ สิทธิ์ และวงจรชีวิตร่วมกับระบบที่เชื่อมต่อ
03 / INDUSTRIAL IoT
เชื่อมข้อมูลจากโรงงาน
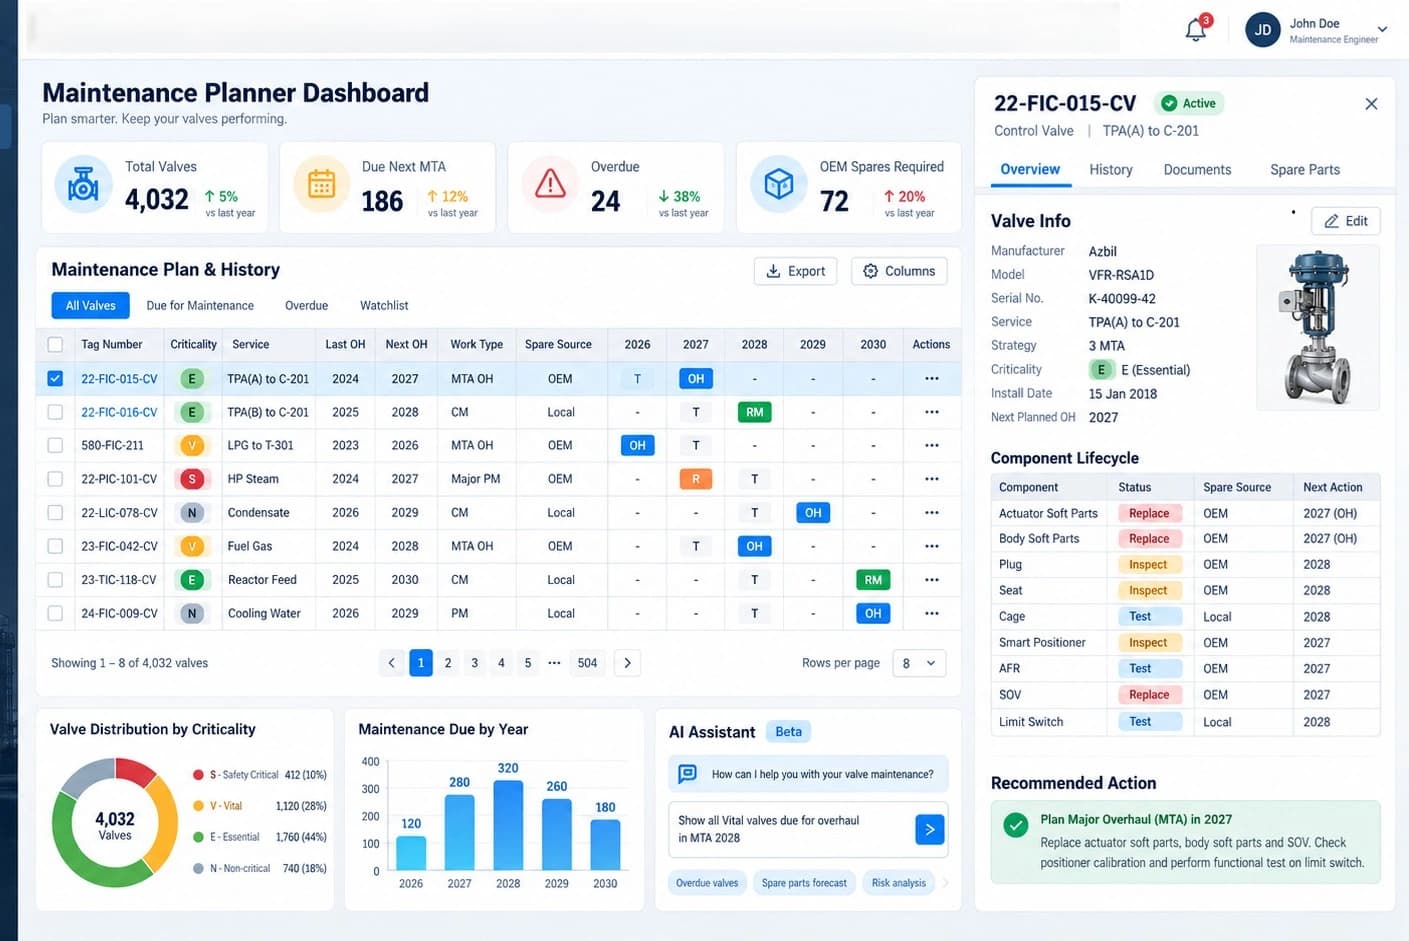
รวมยอดผลิต ค่าวัดคุณภาพ สภาพเครื่องจักร และผลตรวจจากกล้องตามจุดงาน
04 / AI & ANALYTICS
นำข้อมูลไปวิเคราะห์ต่อ
เตรียมข้อมูลให้โมเดล วิเคราะห์แนวโน้ม และส่งผลเข้าสู่รายงานหรือขั้นตอนทำงาน
เหมาะกับงานของคุณหรือไม่?
เหมาะกับใคร
ทีมไอทีและวิศวกรที่ต้องเชื่อมข้อมูลจากหลายระบบ และต้องการเขียน Python เพิ่มได้ตามงาน
เตรียมข้อมูลก่อนคุย
แหล่งข้อมูลหรือระบบเดิม ตัวอย่างข้อมูล และงานที่ต้องการทำอัตโนมัติ
สรุปสั้น
- nimitFlow คือแพลตฟอร์ม Low-Code ของ Inspektion สำหรับสร้าง Data Pipeline (เส้นทางรับ ประมวลผล และส่งต่อข้อมูล) และงานอัตโนมัติ ด้วยการลากโหนดมาต่อกันบน Canvas (พื้นที่วาง Flow)
- nimitFlow ติดตั้งบน Server ขององค์กรด้วย Docker Compose (ชุดติดตั้งแบบคอนเทนเนอร์) ได้ และเชื่อมโหนด AI กับ LLM ที่รันในองค์กรผ่าน Ollama ได้ ข้อมูลจึงไม่ต้องส่งออกนอกเครือข่าย
- ใน nimitFlow งานทั่วไปตั้งค่าผ่านฟอร์มโดยไม่เขียนโค้ด ส่วนงานที่ซับซ้อนใช้โหนด Python ที่รันในพื้นที่แยก (Sandbox) ซึ่งจำกัดการใช้ทรัพยากร
- งาน Enterprise ต่อเติม Data Lakehouse, Data Catalog, Data Governance และการวิเคราะห์ AI ได้ตามขอบเขตโครงการ โดยประเมินเครื่องมือเชื่อมต่อและระบบติดตั้งแยก
- nimitFlow แบบ Cloud Subscription เริ่มต้น 8,000 บาท/เดือน ส่วนแบบติดตั้งในองค์กรประเมินราคาตามจำนวนผู้ใช้และขอบเขตการเชื่อมต่อ
nimitFlow เชื่อมงานของทีมข้อมูลและทีมโรงงานอย่างไร
เมื่อข้อมูลอยู่คนละไฟล์ คนละฐานข้อมูล และคนละแอป การทำรายงานต้องรวบรวมซ้ำและตรวจความถูกต้องใหม่ nimitFlow ใช้ Flow เป็นเส้นทางกลางในการรับ แปลง ประมวลผล และส่งต่อข้อมูล ให้ทีมเห็นขั้นตอนและปรับงานร่วมกันได้
| โจทย์ของทีม | แนวทางเริ่มต้น |
|---|---|
| ทีม IT และข้อมูล | เชื่อมฐานข้อมูล API และไฟล์ สร้าง Data Pipeline พร้อมตรวจคุณภาพก่อนนำไปใช้ |
| ผู้ดูแลข้อมูล | กำหนดความหมาย เจ้าของชุดข้อมูล สิทธิ์ และกฎตรวจร่วมกับ Data Catalog และระบบกำกับดูแล |
| หัวหน้างานและทีมซ่อมบำรุง | รับยอดผลิต ค่าวัด และสภาพเครื่องจักรจากอุปกรณ์หรือแอปหน้างาน แล้วจัดทำรายงานร่วมกัน |
| ทีมวิเคราะห์และผู้บริหาร | นำข้อมูลที่เตรียมไว้มาแสดงแนวโน้ม สร้างรายงาน หรือเชื่อมโมเดล AI ตามโจทย์ที่กำหนด |
เริ่มหนึ่งงาน แล้วค่อยขยาย
เลือกงานที่ทำซ้ำและมีข้อมูลพร้อม เช่น รวมยอดผลิตประจำวันหรือแจ้งเตือนค่าผิดปกติ ทดลอง Flow กับข้อมูลจริงก่อนขยายไปหลายระบบ
สร้างงานอัตโนมัติด้วย Low-Code และ Python
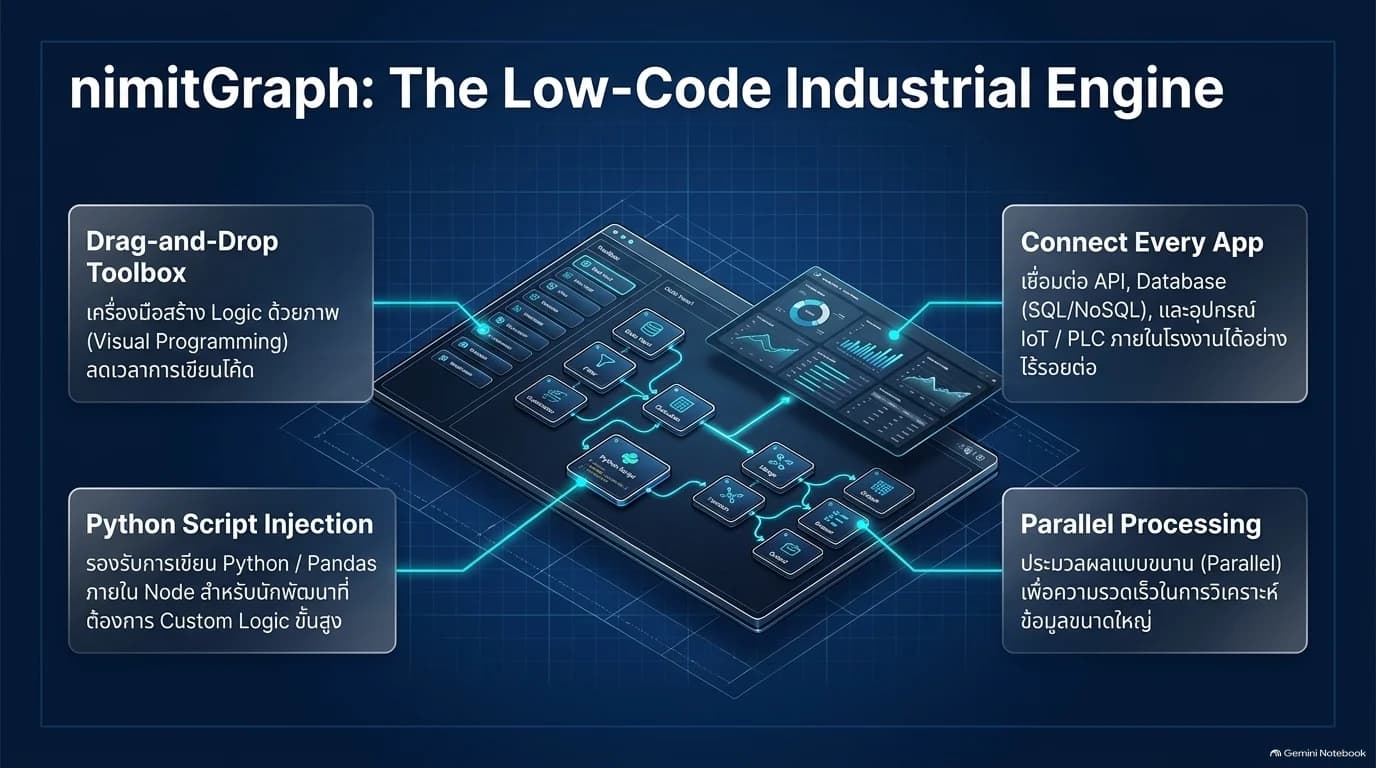
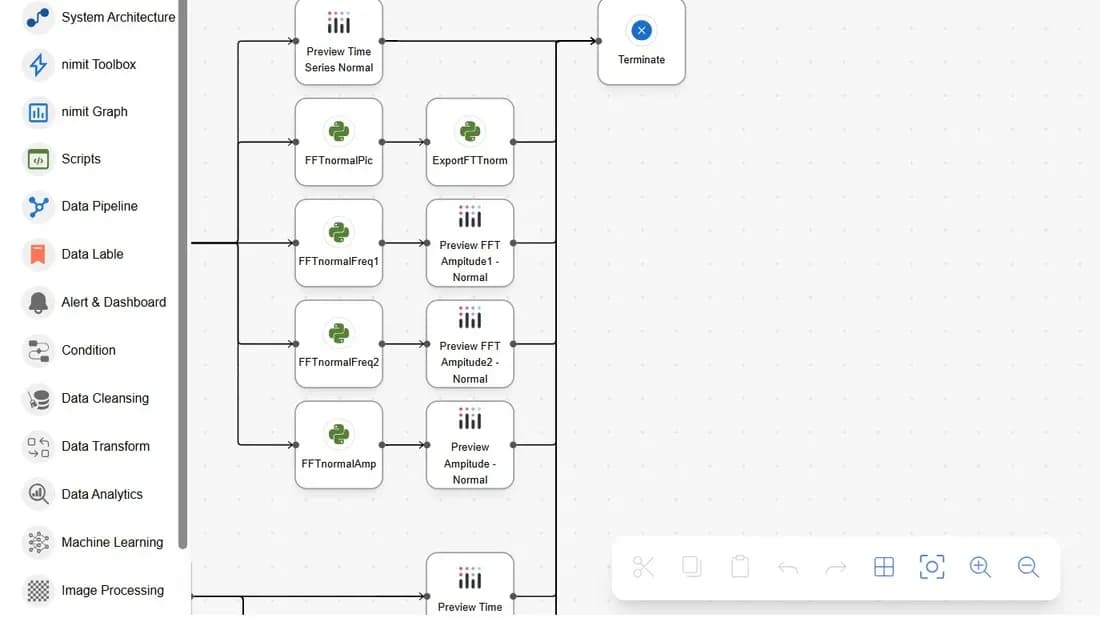
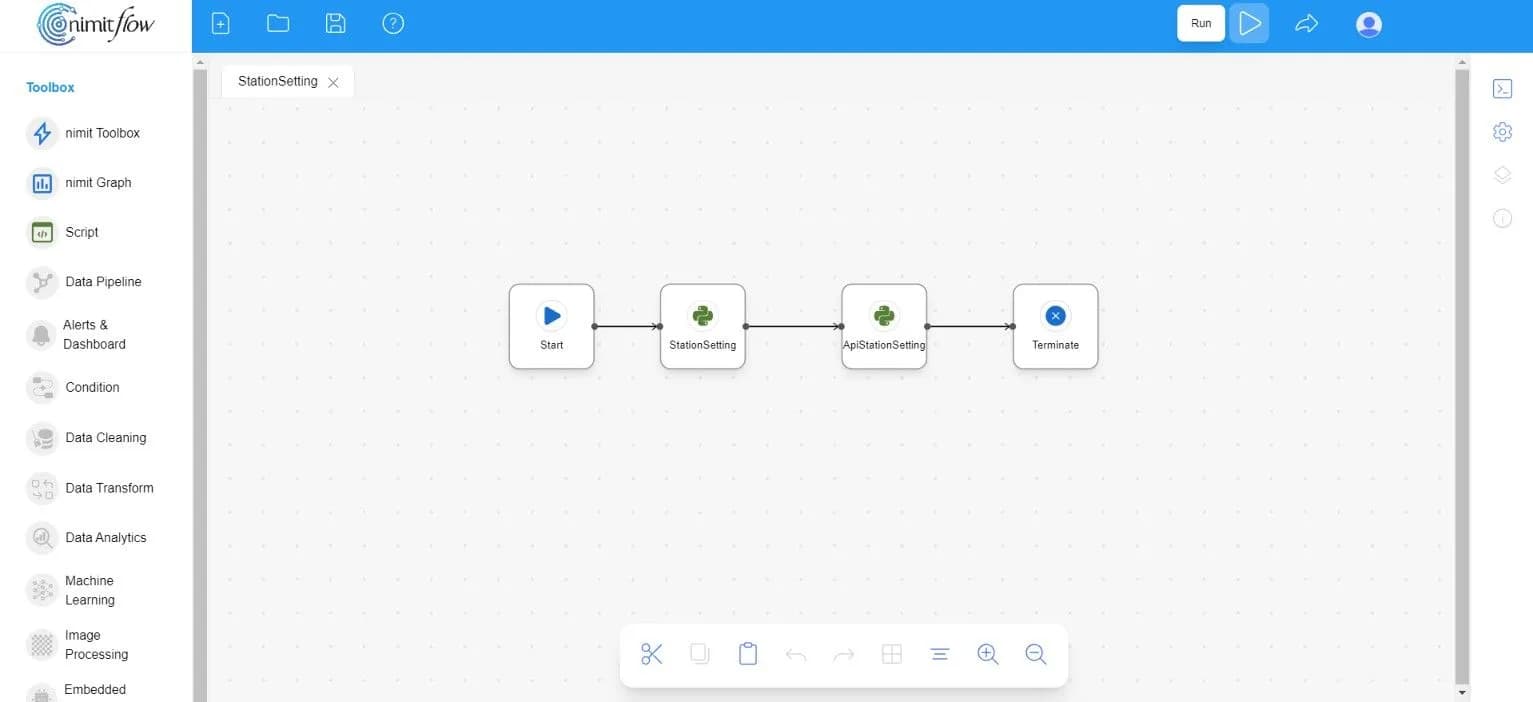
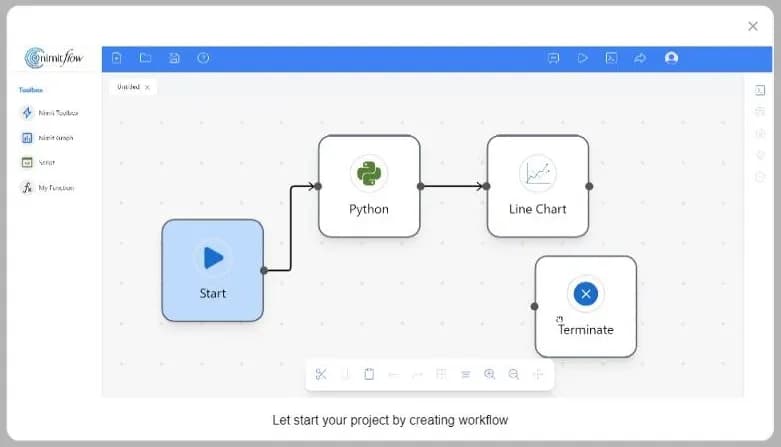
ออกแบบ Flow ด้วยการลากโหนดจาก Toolbox มาต่อกัน กำหนดต้นทาง ขั้นตอนประมวลผล และปลายทาง เอกสารนำเสนอเรียกแนวทางการสร้างงานด้วยภาพนี้ว่า nimitGraph ส่วนงานเฉพาะใช้ Python ภายในโหนดเพื่อกำหนดเงื่อนไขเพิ่มเติม
- 1
รับข้อมูล
เลือก PostgreSQL, MySQL, HTTP/REST, Webhook หรือไฟล์ที่ใช้ในงาน พร้อมตั้งค่าการเข้าถึง
- 2
กำหนดการทำงาน
ต่อโหนดตรวจข้อมูล แปลงค่า คำนวณ วนซ้ำ หรือเรียก Python และ AI ตามลำดับ
- 3
ทดสอบและตั้ง Trigger
ทดลองรัน ตรวจผล แล้วเลือกสั่งเอง ตั้งเวลา หรือรับเหตุการณ์จาก Webhook
- 4
ส่งผลให้ทีมใช้งาน
สร้างกราฟ รายงาน Excel/CSV หรือส่งข้อมูลและแจ้งเตือนผ่านช่องทางที่เชื่อมไว้
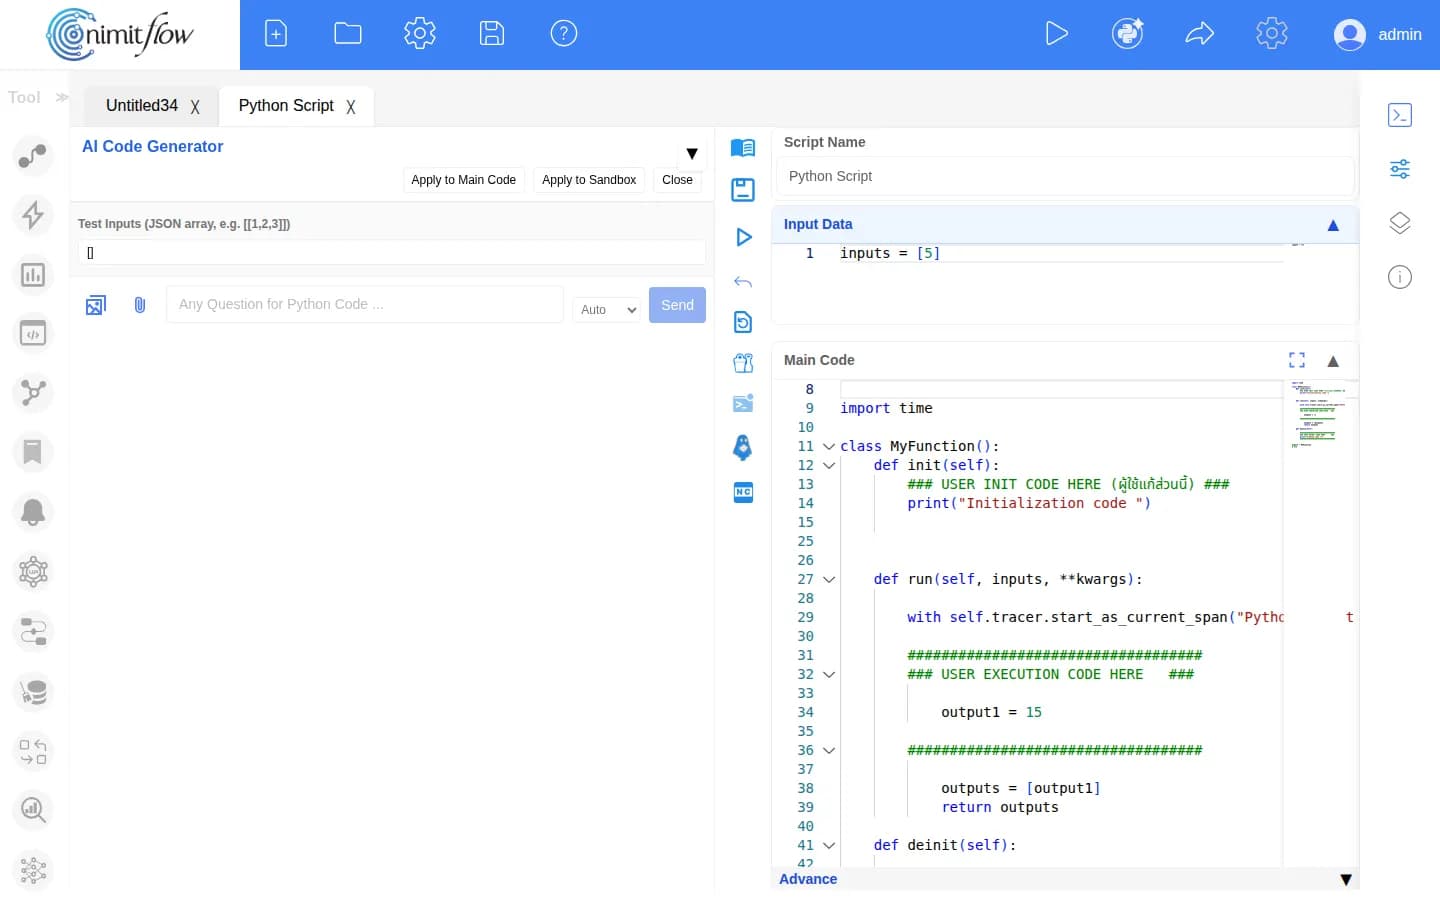
- Python สำหรับเงื่อนไขเฉพาะ และ AI Code Generator ช่วยร่างโค้ดให้ผู้พัฒนาตรวจทานก่อนใช้
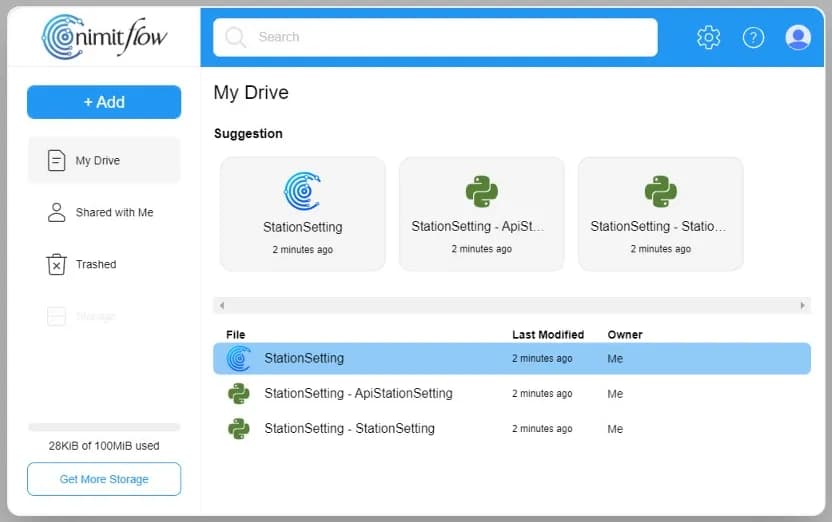
- nimitFlow Drive เก็บไฟล์และแบ่งสิทธิ์เจ้าของ ผู้แก้ไข และผู้ดูอย่างเดียว
- ส่งออกและนำเข้า Flow เป็นไฟล์ .nim เพื่อนำงานกลับมาใช้หรือปรับต่อ
- ระบบหรือฐานข้อมูลที่ไม่มีโหนดสำเร็จรูป เชื่อมเพิ่มเติมผ่าน Python หรือ API ตามช่องทางที่ต้นทางรองรับ
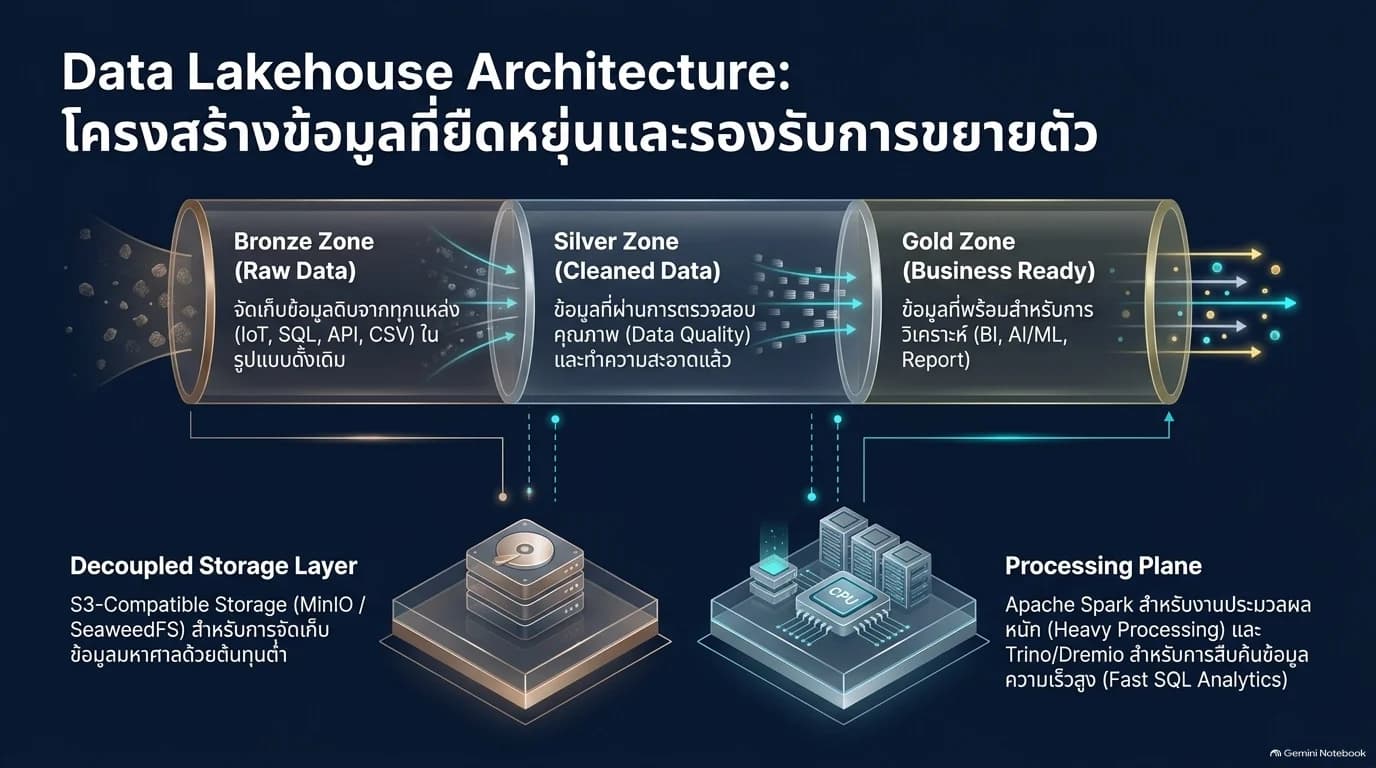
Data Pipeline และ Data Lakehouse: จากข้อมูลดิบสู่ข้อมูลพร้อมใช้
ใช้ nimitFlow จัดเส้นทางข้อมูลจากระบบเดิม SQL/NoSQL, API, ไฟล์ และอุปกรณ์หน้างานเข้าสู่คลังข้อมูลกลาง แยกขั้นตอนจัดเก็บออกจากการประมวลผล เพื่อเลือกทรัพยากรให้เหมาะกับปริมาณข้อมูลและความถี่ที่ต้องการ
| ชั้นข้อมูล | หน้าที่ |
|---|---|
| Bronze / ข้อมูลดิบ | เก็บข้อมูลตามรูปแบบต้นทาง พร้อมที่มาและเวลาที่รับเข้า |
| Silver / ข้อมูลที่ตรวจแล้ว | ทำความสะอาด ตรวจความครบถ้วน และจัดรูปแบบให้ใช้ร่วมกันได้ |
| Gold / ข้อมูลพร้อมใช้ | เตรียมข้อมูลตามโจทย์ของ Dashboard รายงาน BI หรือโมเดล AI |
- เลือกงานรับข้อมูลแบบเป็นรอบ (Batch) หรือรับเหตุการณ์ต่อเนื่อง (Streaming) ตามความพร้อมของต้นทาง
- ออกแบบพื้นที่เก็บไฟล์แบบ S3-compatible และชั้นประมวลผลหรือสืบค้นแยกกันตามโครงการ
- กำหนดอายุข้อมูลแต่ละชั้น การเก็บถาวร และการกู้คืนร่วมกับผู้ดูแลระบบ
เครื่องมือประกอบเลือกตามขนาดงาน
Apache Airflow, Kafka, Spark, Trino/Dremio และ MinIO/SeaweedFS เป็นตัวเลือกในสถาปัตยกรรมอ้างอิง ต้องประเมินการติดตั้งและเชื่อมต่อแยก ไม่ใช่ส่วนที่รวมในทุกแพ็กเกจ nimitFlow
Data Governance: รู้ที่มา ตรวจคุณภาพ และกำหนดสิทธิ์ข้อมูล
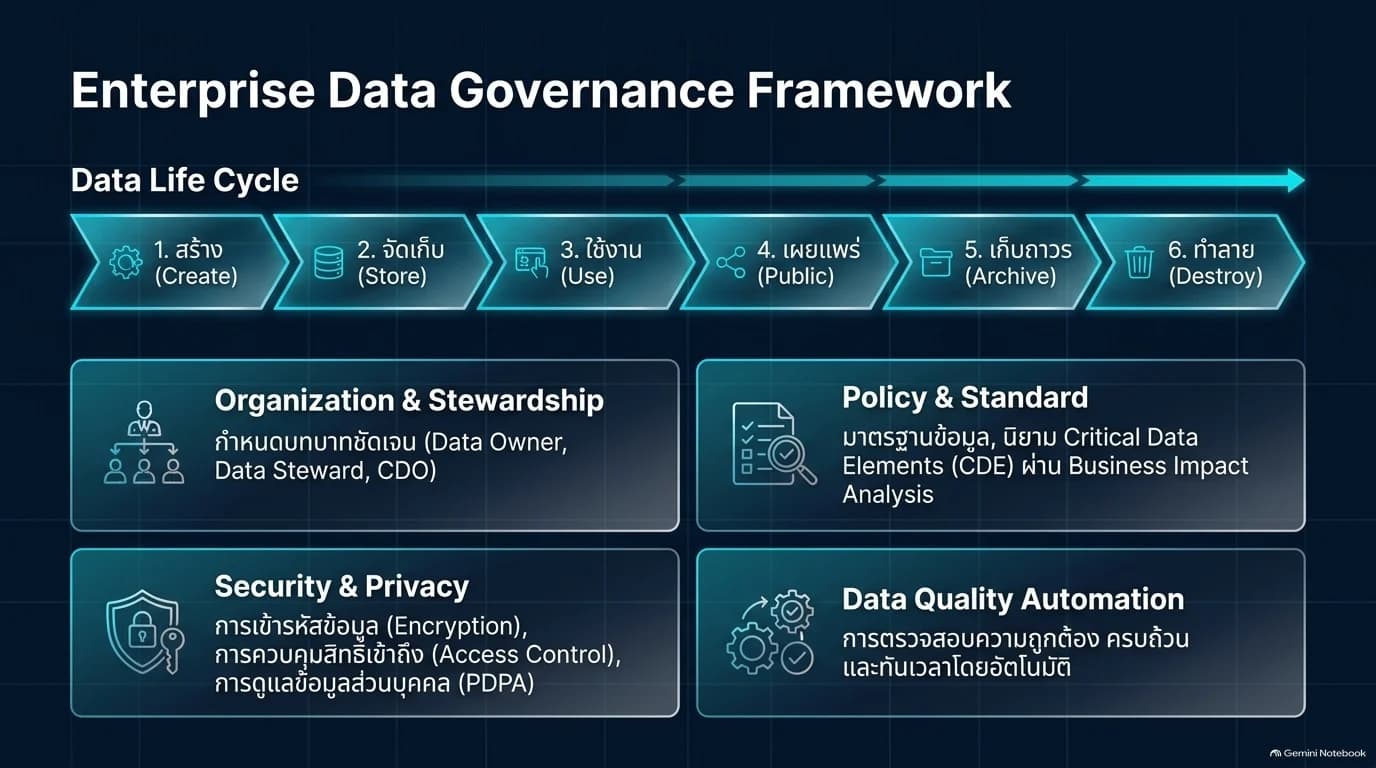
วางการกำกับดูแลควบคู่กับเส้นทางข้อมูล โดยกำหนด Data Owner ผู้รับผิดชอบข้อมูล และ Data Steward ผู้ดูแลความหมายและคุณภาพ นำกฎขององค์กรมาใช้กับ Flow และระบบ Catalog ที่เชื่อมร่วมกัน
- Data Catalog / Metadata: บันทึกคำอธิบาย แหล่งที่มา ผู้ดูแล และหมวดหมู่ของชุดข้อมูลให้ค้นหาได้
- Data Lineage: แสดงว่าข้อมูลผ่านขั้นตอนไหนและถูกนำไปใช้ที่รายงานใด เพื่อวิเคราะห์ผลกระทบเมื่อแก้ต้นทาง
- Critical Data Elements: ระบุข้อมูลสำคัญและกฎตรวจ เช่น ค่าว่าง รูปแบบข้อมูล ความซ้ำ และความครบถ้วน
- Data Quality: ตั้งกฎตรวจและรายงานรายการผิดปกติให้ผู้รับผิดชอบตาม Workflow
- Security: ออกแบบสิทธิ์ การปกปิดข้อมูล และการดูแลคีย์หรือข้อมูลลับร่วมกับระบบที่เลือกติดตั้ง
วงจรชีวิตข้อมูลครอบคลุมการสร้าง จัดเก็บ ใช้งาน เผยแพร่ เก็บถาวร และทำลาย โดยกำหนดผู้รับผิดชอบและเงื่อนไขแต่ละขั้นให้ตรงกับนโยบายองค์กร
- 1
รับคำขอเกี่ยวกับข้อมูล
บันทึกคำขอเข้าถึง แก้ไข หรือจัดการข้อมูลเข้าสู่กระบวนการขององค์กร
- 2
ค้นหาและตรวจสอบ
ใช้ข้อมูล Catalog และช่องทางเชื่อมต่อเพื่อค้นหารายการที่เกี่ยวข้อง พร้อมตรวจสิทธิ์และขอบเขต
- 3
อนุมัติ
ส่งผู้รับผิดชอบตรวจคำขอและอนุมัติก่อนดำเนินการ
- 4
ดำเนินการและเก็บประวัติ
จัดการข้อมูลตามผลอนุมัติ บันทึกผลและหลักฐานให้ตรวจย้อนหลังได้
ขอบเขตงานกำกับดูแล
กฎ สิทธิ์ ผู้อนุมัติ และระยะเวลาดำเนินการต้องกำหนดร่วมกับองค์กร การติดตั้ง Workflow ช่วยรองรับกระบวนการ ไม่ใช่การรับรองว่าองค์กรผ่านข้อกำหนดทั้งหมดโดยอัตโนมัติ
Industrial IoT: เชื่อมข้อมูลจากหน้างานเข้าสู่ภาพรวมโรงงาน
อุปกรณ์และแอปแต่ละจุดมีหน้าที่เฉพาะ nimitFlow ช่วยรับข้อมูลมาใช้ต่อในรายงานหรือ Workflow ร่วมกัน โดยเลือกสัญญาณ อินเทอร์เฟซ และ Gateway ให้ตรงกับเครื่องจักร
| จุดงาน | ข้อมูลที่นำมาเชื่อม |
|---|---|
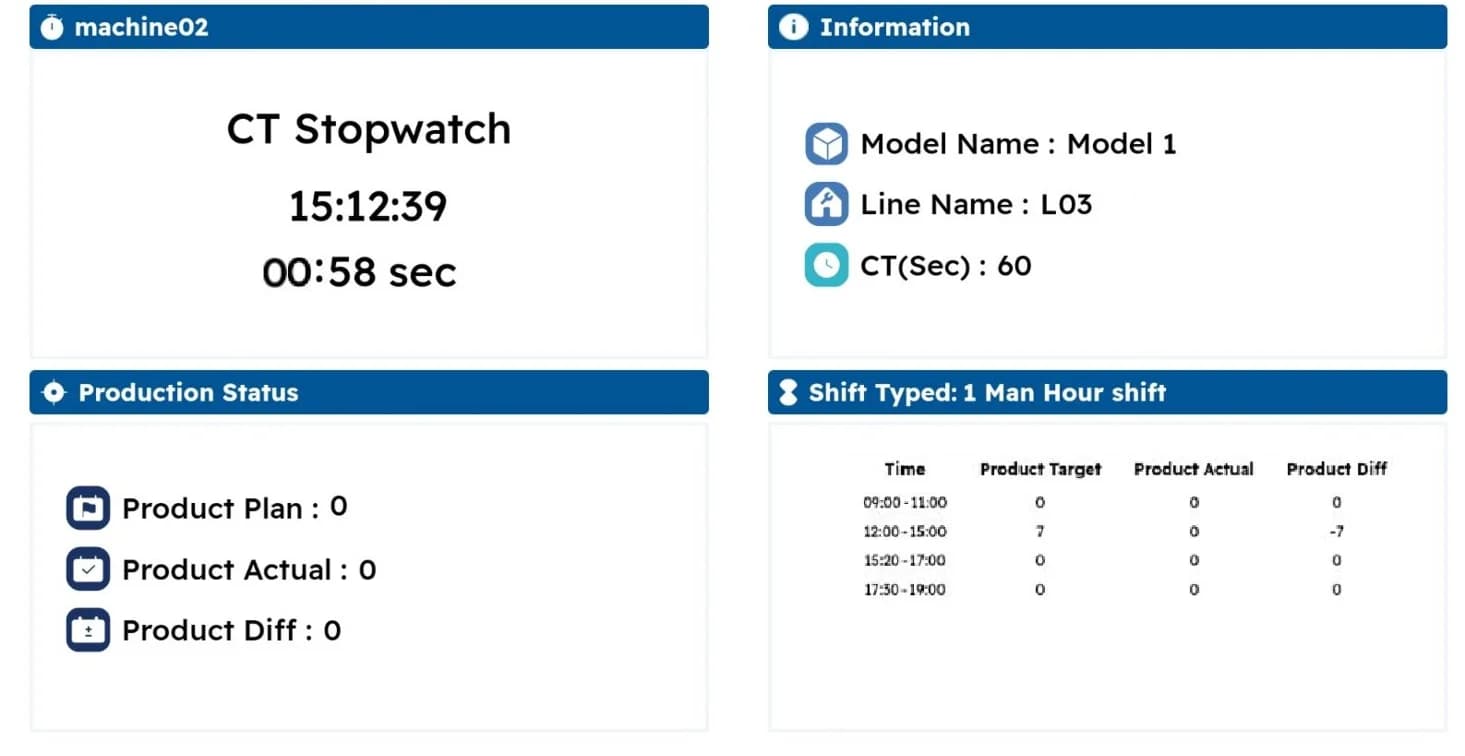
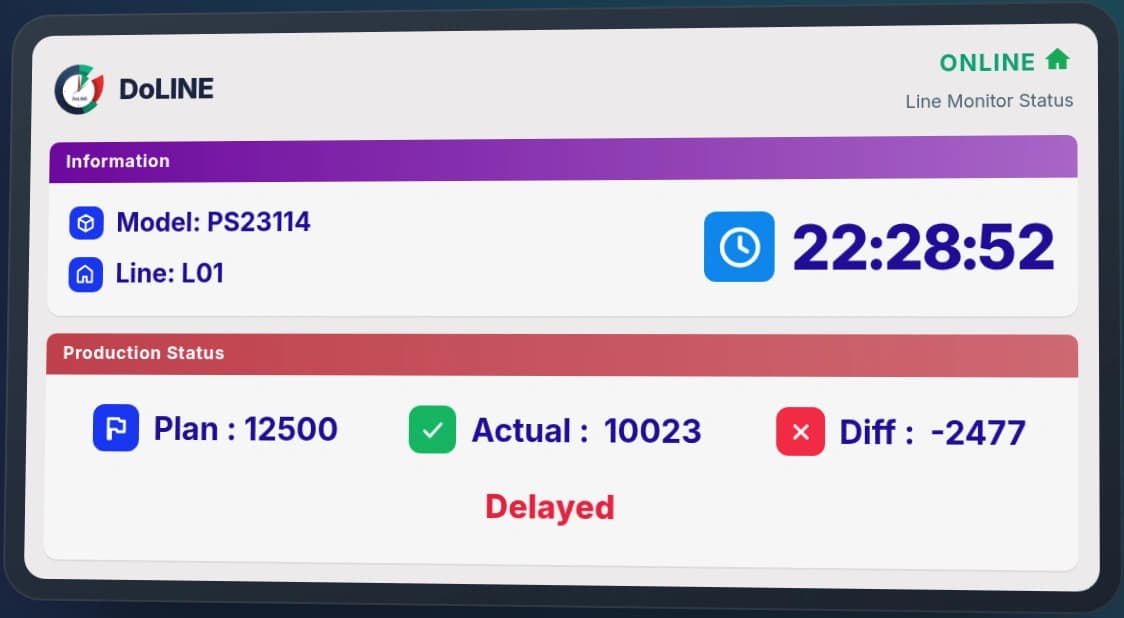
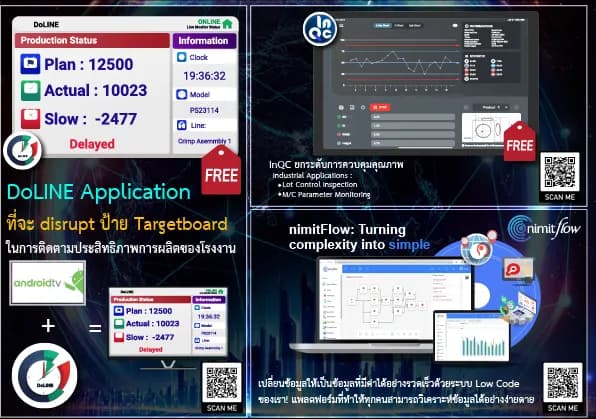
| DoLINE / ยอดผลิต | แผน ยอดผลิตจริง และส่วนต่างจากสถานีผลิต |
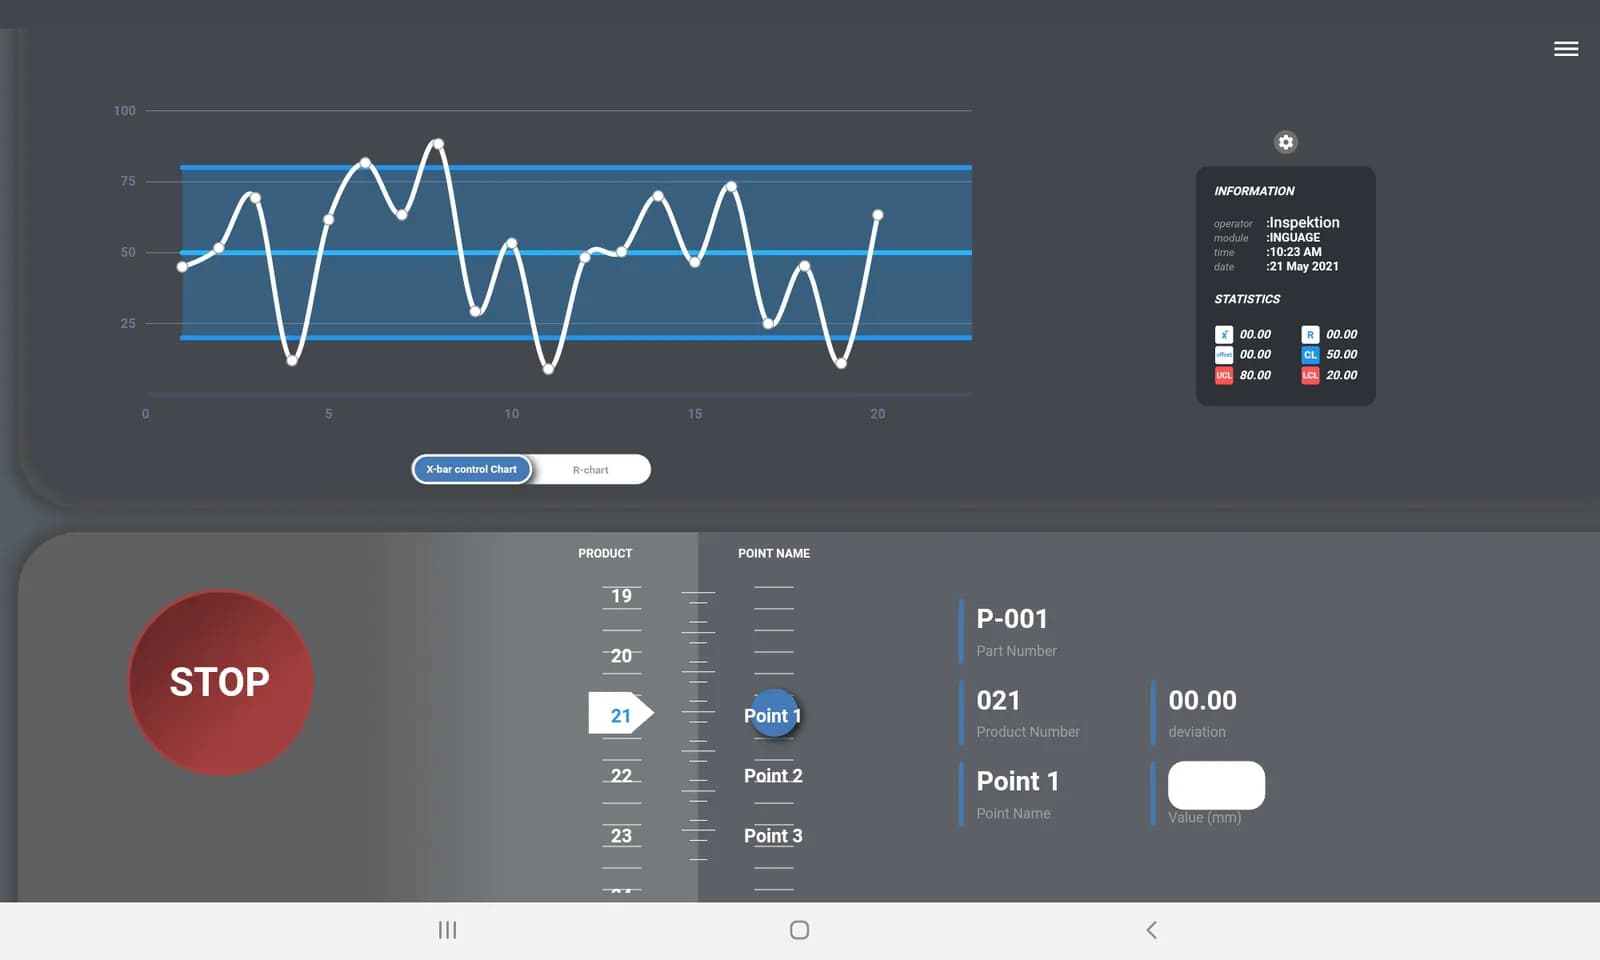
| InQC + InGauge / คุณภาพ | ค่าวัดจากเครื่องมือผ่านอุปกรณ์รับค่า และผลควบคุมคุณภาพ |
| InCBM + InSensor / สภาพเครื่องจักร | ค่าเซ็นเซอร์ที่รับผ่าน InSensor และข้อมูลสภาพเครื่องจักรจากระบบที่เชื่อม |
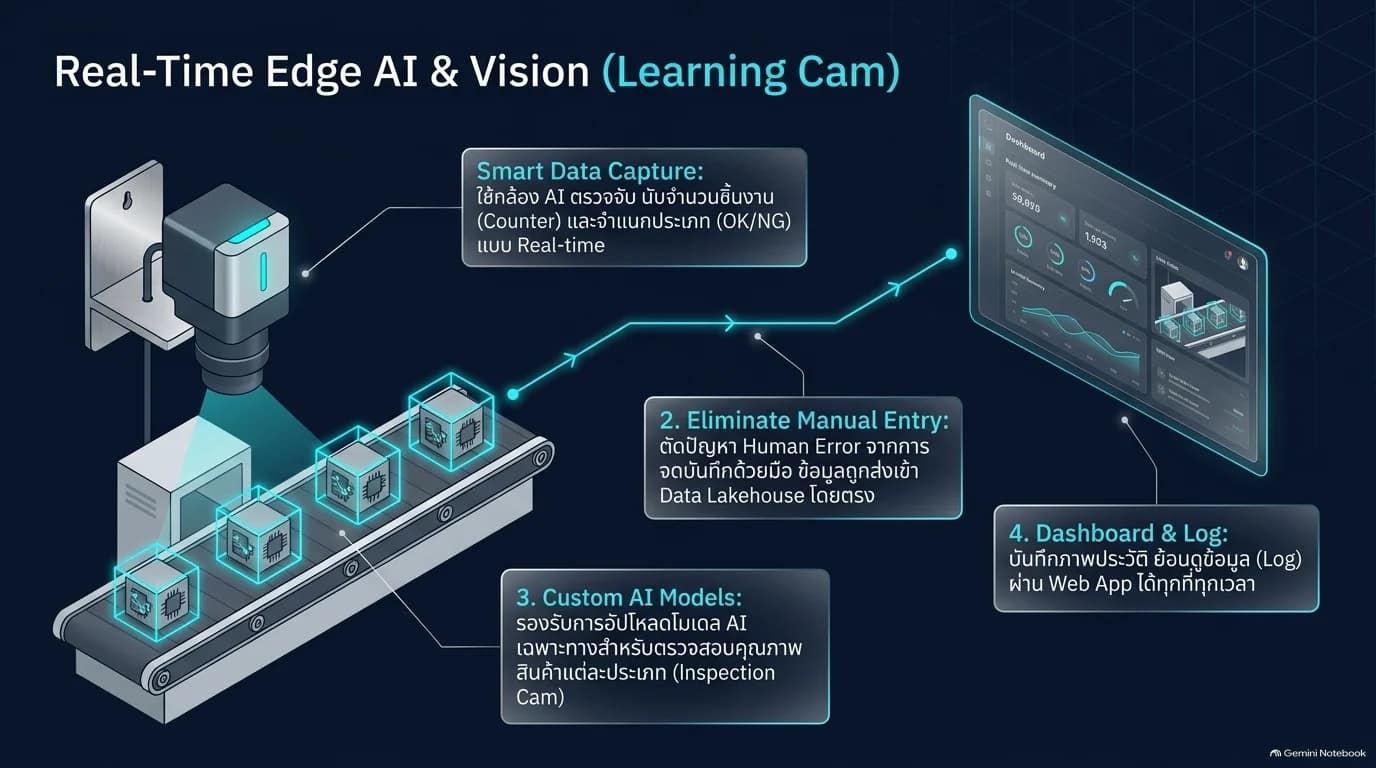
| LearningCam / ตรวจสินค้า | ผลตรวจ นับ หรือจำแนกสินค้าตามโมเดลและเงื่อนไขที่ทดสอบ |
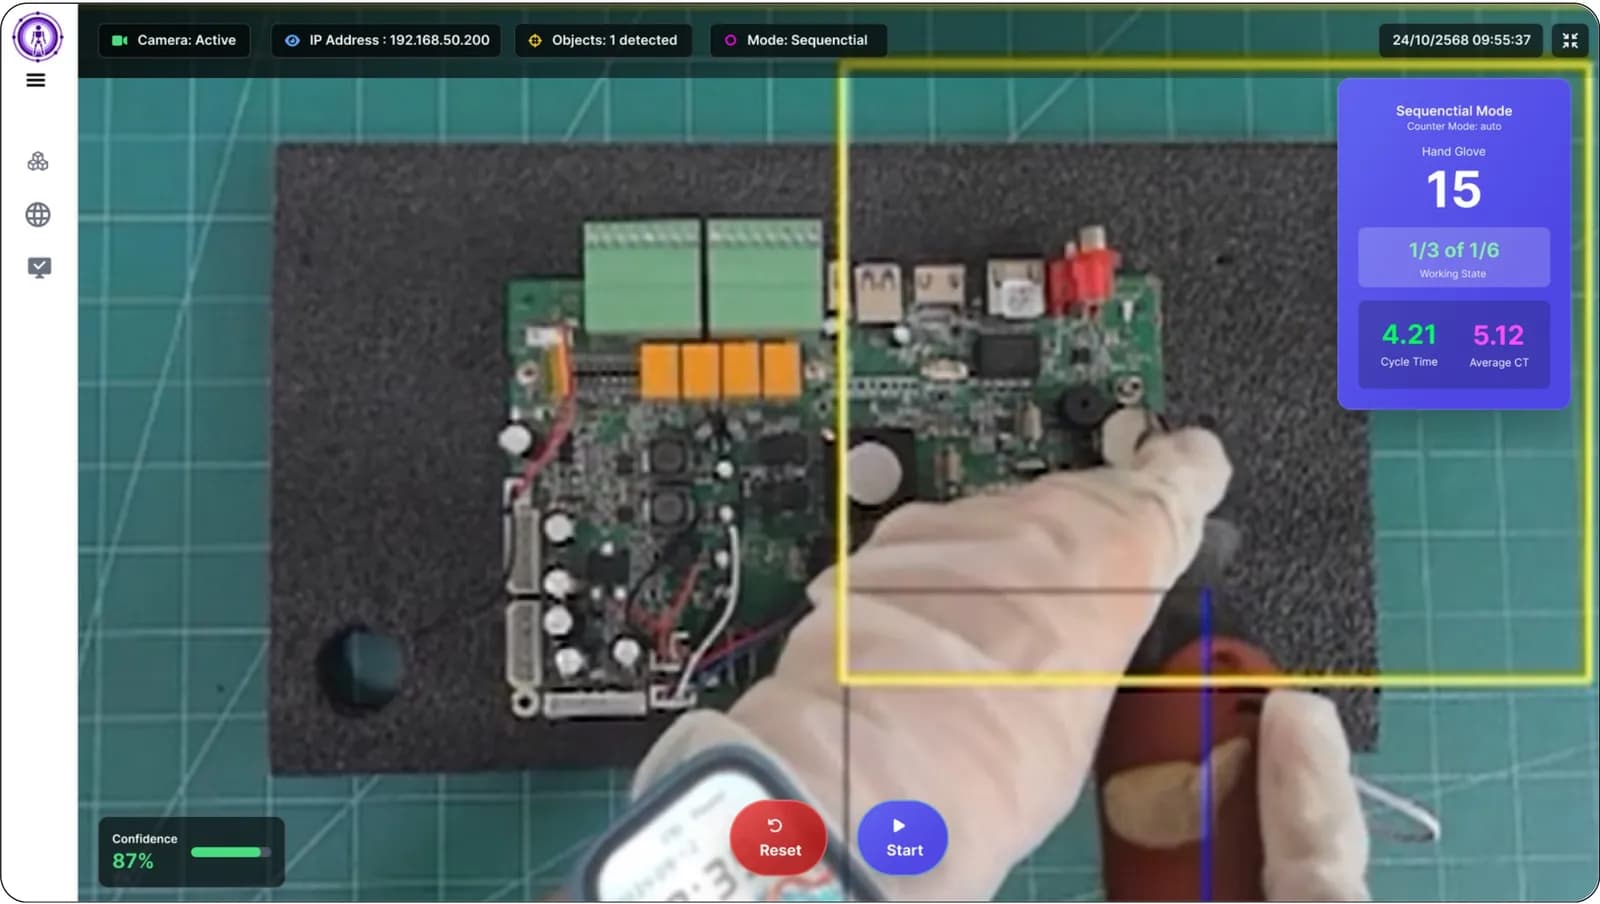
| Task Cam / ขั้นตอนงาน | ผลการตรวจลำดับขั้นตอนและเวลาที่สถานีงาน |
สำหรับงานวิเคราะห์การสั่น สามารถออกแบบลำดับรับข้อมูล → ประมวลผลสัญญาณและกราฟ FFT → วิเคราะห์ตามเกณฑ์หรือโมเดล → ส่งผลให้ทีมซ่อมบำรุง การวิเคราะห์ด้วยโมเดลเป็นงานเพิ่มเติมที่ต้องเตรียมและทดสอบข้อมูล แยกจากการเฝ้าระวังตามเกณฑ์ของ InCBM
AI และ Machine Learning ที่เชื่อมกับขั้นตอนทำงาน
ให้ข้อมูลที่เตรียมและตรวจแล้วเป็นจุดเริ่มของงาน AI ใช้ Flow จัดลำดับการเตรียมข้อมูล เรียกโมเดล และส่งผลวิเคราะห์ไปยังคนหรือระบบที่ต้องใช้งาน
- Time Series และ Anomaly Detection: สร้างตัวแปรจากข้อมูลตามเวลา เปรียบเทียบค่าพื้นฐาน และทดลองตรวจความผิดปกติ
- AI Vision: รับผลตรวจจากกล้องที่ประมวลผลหน้างาน นำไปผูกกับจำนวนผลิต คุณภาพ และประวัติของสถานี
- LLM: เชื่อมโมเดลผ่านโหนด AI หรือใช้ Ollama สำหรับโมเดลที่รันในองค์กร
- Dashboard และรายงาน: แสดงแนวโน้ม ผลโมเดล และสถานะงานร่วมกับข้อมูลที่ผู้ใช้มีสิทธิ์เข้าถึง
ทดสอบก่อนใช้ตัดสินใจ
ความแม่นยำและความเร็วขึ้นกับข้อมูล โมเดล อุปกรณ์ และเงื่อนไขงาน ต้องทดสอบกับข้อมูลที่แยกจากชุดพัฒนาและกำหนดเกณฑ์ยอมรับก่อนใช้งานจริง
เลือกการติดตั้งให้ตรงกับนโยบายและปริมาณงาน
เลือก Cloud Subscription หรือติดตั้งบน Server ขององค์กร (On-Premise) โดยประเมินจำนวนผู้ใช้ แหล่งข้อมูล ความถี่ของ Flow พื้นที่เก็บ และผู้รับผิดชอบการดูแล
| รูปแบบ | สิ่งที่ต้องเตรียม |
|---|---|
| Cloud Subscription | ขอบเขตข้อมูลที่ส่งเข้าระบบ ผู้ใช้ และช่องทางเชื่อมต่อที่องค์กรอนุญาต |
| On-Premise | Server เครือข่าย พื้นที่เก็บข้อมูล ระบบสำรอง และผู้ดูแลภายใน |
| Enterprise / High Availability | ออกแบบส่วนประมวลผลแยก การสำรองและสลับบริการ พร้อมทดสอบการกู้คืนตามขอบเขตงาน |
| เครือข่ายปิด / Air-gapped | ตรวจทุก Flow โมเดล และส่วนประกอบให้ทำงานภายในได้ รวมวิธีติดตั้ง อัปเดต และนำข้อมูลเข้าออก |
สถาปัตยกรรม Enterprise ในเอกสารแยกพื้นที่ Edge, App, Data และ Execution เพื่อออกแบบสิทธิ์และทรัพยากรของแต่ละส่วน แนวทาง Container หรือระบบ Cluster ต้องเลือกให้ตรงกับสภาพแวดล้อมและรุ่นที่นำไปติดตั้ง
กำหนดขอบเขตก่อนเสนอราคา
Data Lakehouse, Catalog, HA, โมเดล AI และอุปกรณ์หน้างานเป็นองค์ประกอบที่ประเมินเพิ่มเติมตามโครงการ จำนวนบริการ อัตรารับข้อมูล และระดับความพร้อมใช้งานต้องอ้างอิงการออกแบบและผลทดสอบของงานนั้น
เริ่มจากโจทย์จริง แล้วกำหนดผลที่ตรวจรับได้
- 1
สำรวจข้อมูลและงานเดิม
รวบรวมต้นทาง ตัวอย่างข้อมูล รูปแบบรายงาน ผู้ใช้ และข้อจำกัดด้านเครือข่าย
- 2
เลือกงานนำร่อง
กำหนด Flow หนึ่งงาน พร้อมผลลัพธ์และเกณฑ์ยอมรับที่ทีมตรวจร่วมกันได้
- 3
เชื่อมและทดสอบ
ทดลองกับข้อมูลจริง ตรวจข้อผิดพลาด สิทธิ์ และการทำงานเมื่อระบบต้นทางหยุด
- 4
ส่งมอบและขยายผล
จัดคู่มือ ผู้รับผิดชอบ การสำรองและติดตามงาน ก่อนเพิ่มแหล่งข้อมูลหรือโมเดล
ประเมินความคุ้มค่าจากเวลารวบรวมข้อมูล งานที่ลดการทำซ้ำ คุณภาพข้อมูลที่ตรวจพบ และค่าใช้จ่ายดูแลระบบขององค์กร ไม่ใช้ตัวเลขประหยัดหรือความแม่นยำจากภาพสาธิตเป็นผลรับรองของทุกโครงการ
สเปคทางเทคนิค
| ประเภท | แพลตฟอร์มซอฟต์แวร์ Low-Code / No-Code สำหรับระบบอัตโนมัติและ Data Pipeline |
|---|---|
| รุ่นปัจจุบัน | nimitFlow 4.02a (ข้อมูล ก.ย. 2569) |
| การใช้งาน | ผ่านเว็บเบราว์เซอร์ |
| รูปแบบติดตั้ง | ติดตั้งบน Server ขององค์กรด้วย Docker Compose (ชุดติดตั้งแบบคอนเทนเนอร์) (On-Premise) หรือ Cloud Subscription |
| เทคโนโลยีเบื้องหลัง | ระบบหลังบ้านภาษา Python · ฐานข้อมูล PostgreSQL · หน้าเว็บ Next.js / React |
| โหนดที่พร้อมใช้ | Python, AI LLM, PostgreSQL, MySQL, HTTP/REST, กราฟหลายแบบ, Loop, Trigger (Manual / Schedule / Webhook), nimitFlow Drive |
| เชื่อมผ่าน Python | MSSQL, MongoDB, InfluxDB, SharePoint, Power BI, Power Apps, Superset, Dremio, OpenMetadata, LINE, อีเมล |
| ไฟล์ Flow | ไฟล์ .nim (ส่งออก/นำเข้า Flow ทั้งชุด) และไฟล์ CSV สำหรับตั้งค่าอุปกรณ์ปลายทาง เช่น บอร์ด DoLINE |
| ที่เก็บไฟล์ | nimitFlow Drive (My Drive, Shared with Me, Trashed) แชร์ได้ตามสิทธิ์ เจ้าของ / แก้ไข / ดูอย่างเดียว |
| ความปลอดภัย | เข้าสู่ระบบด้วย JWT (โทเคนยืนยันตัวตน) · ตรวจสิทธิ์ทุกคำสั่ง · โหนดฐานข้อมูลอ่านอย่างเดียว · เข้ารหัสรหัสผ่านฐานข้อมูล · Python รันใน Sandbox |
| อุปกรณ์ Inspektion ที่ส่งข้อมูลเข้า | Task Cam, InQC, InGauge (ผ่าน InQC), DoLINE, LearningCam, DoRare |
| รายงานและแจ้งเตือน | รายงาน Excel / CSV · แจ้งเตือนผ่านสคริปต์ Python ตามขอบเขตงาน |
สเปก Server ขั้นต่ำ จำนวนผู้ใช้ต่อแพ็กเกจ และพื้นที่จัดเก็บ ยังไม่ได้กำหนดเป็นตัวเลขมาตรฐาน ทีมงานประเมินตามขนาดงาน
สถาปัตยกรรมและการเชื่อมต่อ
FROM SOURCE TO ACTION
วางเส้นทางข้อมูลให้ครบตั้งแต่ต้นทางถึงผู้ใช้งาน
เริ่มจากช่องทางที่ระบบเดิมเปิดให้เชื่อม แล้วจัดลำดับการรับ ตรวจสอบ ประมวลผล และส่งต่อข้อมูลใน nimitFlow
- 01
ข้อมูลต้นทาง
ฐานข้อมูล · API · CSV · เครื่องจักรผ่าน Gateway · ผลจากแอปหน้างาน
- 02
nimitFlow
Trigger → รับข้อมูล → ตรวจและแปลง → Python / AI → ส่งผล
- 03
นำข้อมูลไปใช้
Dashboard · รายงาน · แอปโรงงาน · คลังข้อมูลและระบบองค์กร
ขยายโครงสร้างตามปริมาณงานและนโยบายข้อมูล
เซ็นเซอร์ กล้อง และ Gateway ที่จุดงาน เช่น InSensor สำหรับรับข้อมูลเครื่องจักร
หน้าเว็บ บัญชีผู้ใช้ API และกฎการเข้าถึง
ฐานข้อมูล ที่เก็บไฟล์ และ Lakehouse ที่เลือกใช้
Worker ประมวลผล Flow สคริปต์ Python และงานวิเคราะห์
Cloud และ On-Premise เป็นทางเลือกติดตั้ง ส่วน HA, เครือข่ายปิด และการขยาย Worker ต้องออกแบบและทดสอบตามระบบจริง รวมถึงตรวจการเรียกบริการภายนอกในแต่ละ Flow
ระบบที่เชื่อมต่อได้
- PostgreSQL
- MySQL
- HTTP / REST API
- Webhook
- API เชื่อม ERP / MES
- LLM: Gemini · Claude · ChatGPT · DeepSeek
- Ollama (LLM ในองค์กร)
- MSSQL · MongoDB · InfluxDB (ผ่าน Python)
- SharePoint · Power BI · Power Apps (ผ่าน Python)
- LINE · อีเมล (ผ่าน Python ตามขอบเขตงาน)
- Task Cam
- InQC
- DoLINE
- LearningCam
- InCBM
ความต้องการระบบ
- ผู้ใช้เข้าใช้งานผ่านเว็บเบราว์เซอร์ ไม่ต้องติดตั้งโปรแกรมที่เครื่องผู้ใช้
- แบบติดตั้งในองค์กร: Server ระบบปฏิบัติการ Ubuntu ติดตั้งทั้งระบบด้วย Docker Compose (ชุดติดตั้งแบบคอนเทนเนอร์) ชุดเดียว
- รองรับงานที่มากขึ้นด้วยการเพิ่มตัวประมวลผลงาน (Worker)
- ใช้ AI ในองค์กร: เครื่องที่รัน LLM ผ่าน Ollama, LM Studio หรือ llama.cpp ในเครือข่ายเดียวกัน
- แบบ Cloud Subscription: ไม่ต้องจัดหาหรือดูแล Server เอง
แพ็กเกจการใช้งาน
รูปแบบลิขสิทธิ์
สมัครใช้งานแบบรายรอบ (Subscription)
แบบ Cloud Subscription คิดค่าบริการรายเดือน เริ่มต้น 8,000 บาท/เดือน ส่วนแบบติดตั้งบน Server ขององค์กร (On-Premise) ประเมินราคาตามจำนวนผู้ใช้และขอบเขตการเชื่อมต่อ
- ราคาไม่รวม VAT
- ขอใบเสนอราคาแบบติดตั้งในองค์กรได้จากทีมงาน
เลือกรูปแบบการใช้งานตามนโยบายข้อมูลและงบประมาณขององค์กร
Cloud Subscription
เริ่มต้น 8,000 บาท/เดือน
- ใช้งานผ่านเว็บ ไม่ต้องดูแล Server เอง
- ระบบอัปเดตฟีเจอร์ต่อเนื่อง
ติดตั้งในองค์กร (On-Premise)
ขอใบเสนอราคา
- ติดตั้งบน Server ขององค์กรด้วย Docker Compose (ชุดติดตั้งแบบคอนเทนเนอร์)
- ข้อมูลและ AI ทำงานอยู่ในเครือข่ายขององค์กร
- ราคาตามจำนวนผู้ใช้และขอบเขตการเชื่อมต่อ
ราคาไม่รวม VAT — รายละเอียดขึ้นกับจำนวนผู้ใช้และขอบเขตการเชื่อมต่อ
อุตสาหกรรมที่ใช้
- โรงงานผลิตทั่วไป
- พลังงาน (งานซ่อมบำรุงโรงกลั่น)
- บริการ
- ชิ้นส่วนยานยนต์ (งานต้นแบบ)
ภาพหน้าจอ
เริ่มต้นใช้งานอย่างไร
nimitFlow ไม่เปิดให้ดาวน์โหลดใช้งานเอง เพราะต้องออกแบบ Flow ให้ตรงกับข้อมูลและขั้นตอนงานของแต่ละองค์กร ขั้นตอนเริ่มต้นคือ นัดเดโม่ เลือกงานนำร่องหนึ่งงาน แล้วทดลองกับข้อมูลจริงขององค์กร ทีมวิศวกรของเราช่วยประเมินความพร้อมและออกแบบ Flow ให้
เตรียมอะไรมาบ้าง
- รายการแหล่งข้อมูลที่จะเชื่อม เช่น อุปกรณ์ Inspektion ที่มีอยู่ (InQC, DoLINE, Task Cam, InGauge) ฐานข้อมูล เซนเซอร์ หรือระบบ ERP/MES เดิม
- ตัวอย่างข้อมูลจริง เช่น ไฟล์ Excel/CSV หรือแบบฟอร์มกระดาษที่ใช้อยู่หน้างาน
- งานที่ต้องการทำอัตโนมัติ เช่น รายงานที่ทำซ้ำทุกวัน หรือเงื่อนไขที่ต้องแจ้งเตือนผ่าน LINE หรืออีเมล พร้อมรายชื่อผู้รับแจ้งเตือน
- รูปแบบติดตั้งที่ต้องการ — Cloud หรือติดตั้งบน Server ขององค์กร (On-Premise) ตามนโยบายข้อมูล และต้องการใช้ AI ในองค์กรหรือไม่
- จำนวนผู้ใช้โดยประมาณ และขอบเขตการเชื่อมต่อ ซึ่งใช้ประกอบการคิดราคา
คำถามที่พบบ่อย
nimitFlow คืออะไร ใช้ทำอะไรได้บ้าง?
nimitFlow เป็นแพลตฟอร์ม Low-Code สำหรับเชื่อมข้อมูลและสร้างงานอัตโนมัติด้วย Flow ใช้รับข้อมูลจากฐานข้อมูล API และหน้างาน ประมวลผลด้วย Python หรือ AI และส่งผลเป็นรายงานหรือการแจ้งเตือน สามารถต่อเติมคลังข้อมูลและงานกำกับดูแลตามโครงการ
ต้องเขียนโค้ดเป็นไหม?
งานทั่วไปตั้งค่าผ่านฟอร์มและต่อโหนดได้ งานเฉพาะใช้ Python และมี AI Code Generator ช่วยร่างโค้ดให้ผู้พัฒนาตรวจทาน Low-Code ลดการเขียนโค้ดซ้ำ แต่ยังต้องออกแบบและทดสอบ Flow ให้ตรงกับข้อมูลจริง
ราคาเท่าไร และ Data Lakehouse รวมในราคาเริ่มต้นหรือไม่?
Cloud Subscription เริ่มต้น 8,000 บาท/เดือน ไม่รวม VAT ส่วน On-Premise และงาน Enterprise ประเมินตามขอบเขต Data Lakehouse, Catalog, HA, โมเดล AI และอุปกรณ์หน้างานต้องประเมินแยก ไม่ใช่สิ่งที่รวมทั้งหมดในราคาเริ่มต้น
ติดตั้งในองค์กรหรือเครือข่ายปิดได้ไหม?
nimitFlow ติดตั้งบน Server ขององค์กรได้ และเลือกใช้ LLM ภายในผ่าน Ollama ได้ งานเครือข่ายปิดต้องตรวจทุก Flow โมเดล และส่วนประกอบไม่ให้พึ่งบริการภายนอก พร้อมออกแบบวิธีอัปเดตและดูแลระบบร่วมกับผู้รับผิดชอบขององค์กร
เชื่อมข้อมูลเครื่องจักรเข้า nimitFlow อย่างไร?
เซ็นเซอร์หรือ PLC ต้องมีช่องทางอ่านค่าที่รองรับ โดยเลือก Gateway เช่น InSensor ให้ตรงกับสัญญาณ แล้วส่งข้อมูลเข้า Flow เพื่อตรวจ แปลง และนำไปใช้กับแอป เช่น InCBM หรือรายงานของโรงงาน ทีมงานประเมินอินเทอร์เฟซและเงื่อนไขแต่ละเครื่องก่อนติดตั้ง
ต้องติดตั้งทุกองค์ประกอบในภาพรวมพร้อมกันไหม?
ไม่จำเป็น เริ่มจาก Flow และแหล่งข้อมูลที่ต้องใช้ก่อน แล้วเพิ่มคลังข้อมูล เครื่องมือกำกับดูแล โมเดล AI หรือระบบสำรองเมื่อมีโจทย์และทรัพยากรพร้อม ภาพในเอกสารแสดงแนวทางโซลูชัน ไม่ใช่รายการที่รวมในทุกแพ็กเกจ